如何与大模型交互-Prompt

系列文章见: 《回忆AI时代-从图灵机到人工智能》

Prompt的来源

大模型目前主要的交互方式是Prompt(提示词,下文统称”提示词“),因为大模型本质上是一个根据已有内容继续预测下一个Token的模型,假设模型内部其实一直在做这样的事情:

1
2
3
今天的天气很好,
↓↓↓
预测下一个 Token

如果你什么都不给它,它不知道应该生成什么。所以你必须给它一个开头如”请介绍一下机器学习”,告知大模型朝哪个方向继续生成,这就是”提示词“这个词的来源。

如何与大模型交互

为什么不是问题

那大模型什么输入的不叫问题? 来看一下问题与提示词差别:

Question(问题) Prompt(提示)
一定是疑问句 不一定是问题
主要用于提问 可以是任何输入
例如:”什么是 AI?” 可以是一篇文章、一段代码、一张表格、一段角色设定等

我们聊天也叫Prompt、让模型生成一张图片也是prompt。

如何写好一个提示词

在日常应用大模型过程中写好一个提示词至关重要,它能帮你解决问题的同时还可以帮您节约Token的输出量,而Token量的节约也就是为你节约成本,因为目前大模型主要的计费方式就是Token。这里推荐一个实用的框架:

项目 含义 示例
C(Context) 背景 我正在学习大模型
O(Objective) 目标 帮我理解 Token
S(Style) 风格 通俗易懂
T(Tone) 语气 像老师讲课
A(Audience) 受众 零基础程序员
R(Response) 输出格式 Markdown,包含流程图和示例

提示词示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
角色:
你是一位人工智能领域的大学教授。

任务:
请讲解什么是 Transformer。

背景:
我是一个刚学习深度学习的人,
已经掌握Python和神经网络,
但没有学习过Attention。

要求:
1. 从为什么需要Transformer开始
2. 再讲Self-Attention
3. 最后讲Encoder和Decoder
4. 使用生活中的例子
5. 尽量不要使用复杂数学公式

输出:
使用Markdown,
包含流程图,
最后给出一个PyTorch示例。

一个好的Prompt并不是越长越好,而是目标明确、上下文充分、要求具体、输出格式清晰。当你把模型当作一位专业人士,清楚地说明”你是谁、要做什么、为什么做、希望如何输出”,回答质量通常会明显提升!
深度学习为什么强大?神经网络的发展与突破!

系列文章见: 《回忆AI时代-从图灵机到人工智能》

什么是深度学习

深度学习是一种机器学习方法,采用多层神经网络(称为深度神经网络)模拟人脑的决策机制。深度学习为大多数人工智能 (AI) 应用提供动力,广泛应用于图像识别、语音识别和自然语言处理 (NLP)等领域。 这里的“深度”是:

1
2
3
4
5
6
7
8
9
10
11
输入层(图片像素)

隐藏层1(识别边缘)

隐藏层2(识别纹理)

隐藏层3(识别眼睛、耳朵)

隐藏层4(组合成猫的特征)

输出层(判断是否为猫)

层数越多,网络就越“深”。

深度学习的演变

2006年,通常被认为是现代深度学习的起点,Geoffrey Hinton发表论文《A Fast Learning Algorithm for Deep Belief Nets》提出逐层预训练方法,解决深层网络训练困难的问题。

2012年,图像识别竞赛中(ImageNet Large Scale Visual Recognition Challenge),Geoffrey Hinton团队开发的AlexNet取得压倒性胜利,错误率传统方法26%,AlexNet15%。从此业界开始关注并投入深度学习,深度学习进入了黄金时代。

Read More

五步工作法

马斯克常被总结的“五步工作法”(也有人叫“工程/效率五步法”)核心思想是:不断删减复杂度,把事情推到极简,然后再自动化。

  • 1.质疑需求:不要一开始就接受“别人说必须这样做”。

    • 这个功能真的必要吗?
    • 有没有人只是“习惯性加上去”的?
    • 如果从零开始设计,还需要它吗?
  • 2.删除:如果某个东西“不必要”,直接删掉。

    • “如果你不需要添加回去,那就应该删除它。”
  • 3.简化:在已经简化的基础上再提速。

    • 流程从10步变3步
    • 结构从多层变一层
    • UI 从复杂变直觉
  • 4.加速:在已经简化的基础上再提速。

    • 并行执行
    • 缩短反馈周期
    • 提前验证关键假设
  • 5.自动化:马斯克非常反感“过早自动化”,因为:“如果流程还没稳定,自动化只会放大错误。”只有在:

    • 流程稳定
    • 已经简化
    • 提前验证关键假设

才值得自动化。

从M-P神经元到感知机再到BP神经网络

系列文章见: 《回忆AI时代-从图灵机到人工智能》

本章目录

关于神经网络的演进

1943年,神经生理学家Warren McCulloch(沃伦·麦卡洛克)与数理逻辑学家 Walter Pitts(沃尔特·皮茨)提出了人类历史上首个人工神经元数学模型,M-P神经元模型(McCulloch-Pitts Neuron),它是一种模仿生物神经元工作方式的计算模型,奠定了人工神经网络的理论基础。

但它很快遇到了一个关键问题,没有学习能力。模型中的权重需要人工设定,只能完成简单的逻辑推理任务(AND、OR 等),无法根据数据自动调整自身参数。


1948年,图灵在《Intelligent Machinery》中提出了”无组织机器(Unorganized Machines)”模型,系统探讨了由大量简单计算单元组成并能够学习的网络结构,虽然当时这些想法尚未真正落地,但这篇论文对后来的神经网络、机器学习以及深度学习的发展产生了深远影响,被认为是人工智能早期的重要理论基础之一。


1958年,心理学家和计算机科学家Frank Rosenblatt提出了感知机(Perceptron)。他在M-P模型的基础上引入了权重自动调整机制,使模型能够根据训练数据学习规律,从而解决了“无法训练”的核心缺陷。

感知机成为历史上第一个真正具备学习能力的神经网络模型,开启了机器学习研究的新阶段。

1969年,人工智能先驱Marvin Minsky与Seymour Papert合著了《Perceptrons》一书系统指出了单层感知机的核心局限,如

  • 只能解决线性可分问题;
  • 无法处理 XOR(异或)等非线性问题;
  • 网络结构过于简单,仅包含单层神经元。

此后1974–1980年间进入了AI的寒冬期。


1986年,David Rumelhart、Geoffrey Hinton和Ronald Williams等人,系统推广了BP神经网络(Backpropagation Neural Network)。

BP神经网络通过反向传播(Backpropagation)算法训练多层神经网络,使网络能够自动学习隐藏层中的复杂特征,成功解决了单层感知机无法处理XOR等非线性问题的缺陷。然而,随着网络层数增加,新的挑战也逐渐显现:

  • 计算量巨大,而当时 CPU 性能有限;
  • 容易出现梯度消失或梯度爆炸问题;
  • 缺乏大规模训练数据;
  • 存储和计算资源不足。

因此,神经网络研究在随后再次进入低潮期。

Read More

如何理解机器学习

系列文章见: 《回忆AI时代-从图灵机到人工智能》

什么是机器学习

机器学习(Machine Learning, ML)本质就是让计算机“通过数据自己学规律”,而不是人手写规则。

举个例子:如下房价面积表格,人一眼就能看出来这里的规律是”面积 * 2 = 房价“,机器学习的目标就是,不告诉机器公式,让它自己从数据中学出来。

面积(㎡) 房价(万)
50 100
60 120
70 140
80 160

用一个Python程序来举例学习房价表格的规律:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
 # 训练数据
x = [50, 60, 70, 80]
y = [100, 120, 140, 160]

# 机器随机猜一个参数
w = 1.0

# 学习率
lr = 0.0001

# 训练10000次
for epoch in range(10000):

grad = 0

# 计算梯度
for xi, yi in zip(x, y):
pred = w * xi
grad += (pred - yi) * xi

# 更新参数
w = w - lr * grad

print("学到的参数:", w)

# 预测
area = 90
price = w * area

print("90平米预测房价:", price)

运行结果大概:

1
2
学到的参数: 2.0
90平米预测房价: 180

程序运行逻辑:

1
2
3
4
5
6
7


算错多少

调整

再猜

譬如:

1
w = 1

于是

1
2
50㎡ -> 50万
60㎡ -> 60万

然后计算误差:

1
2
3
4
真实值: 100
预测值: 50

误差 = 50

根据误差调整参数:

1
w = w - lr * grad

最终 w=2,和我们人算出来的一样,这就是机器学习,用一句话解释它规则 + 数据 = 结果

Read More

1956年人工智能诞生的那个夏天!

系列文章见: 《回忆AI时代-从图灵机到人工智能》

达特茅斯会议

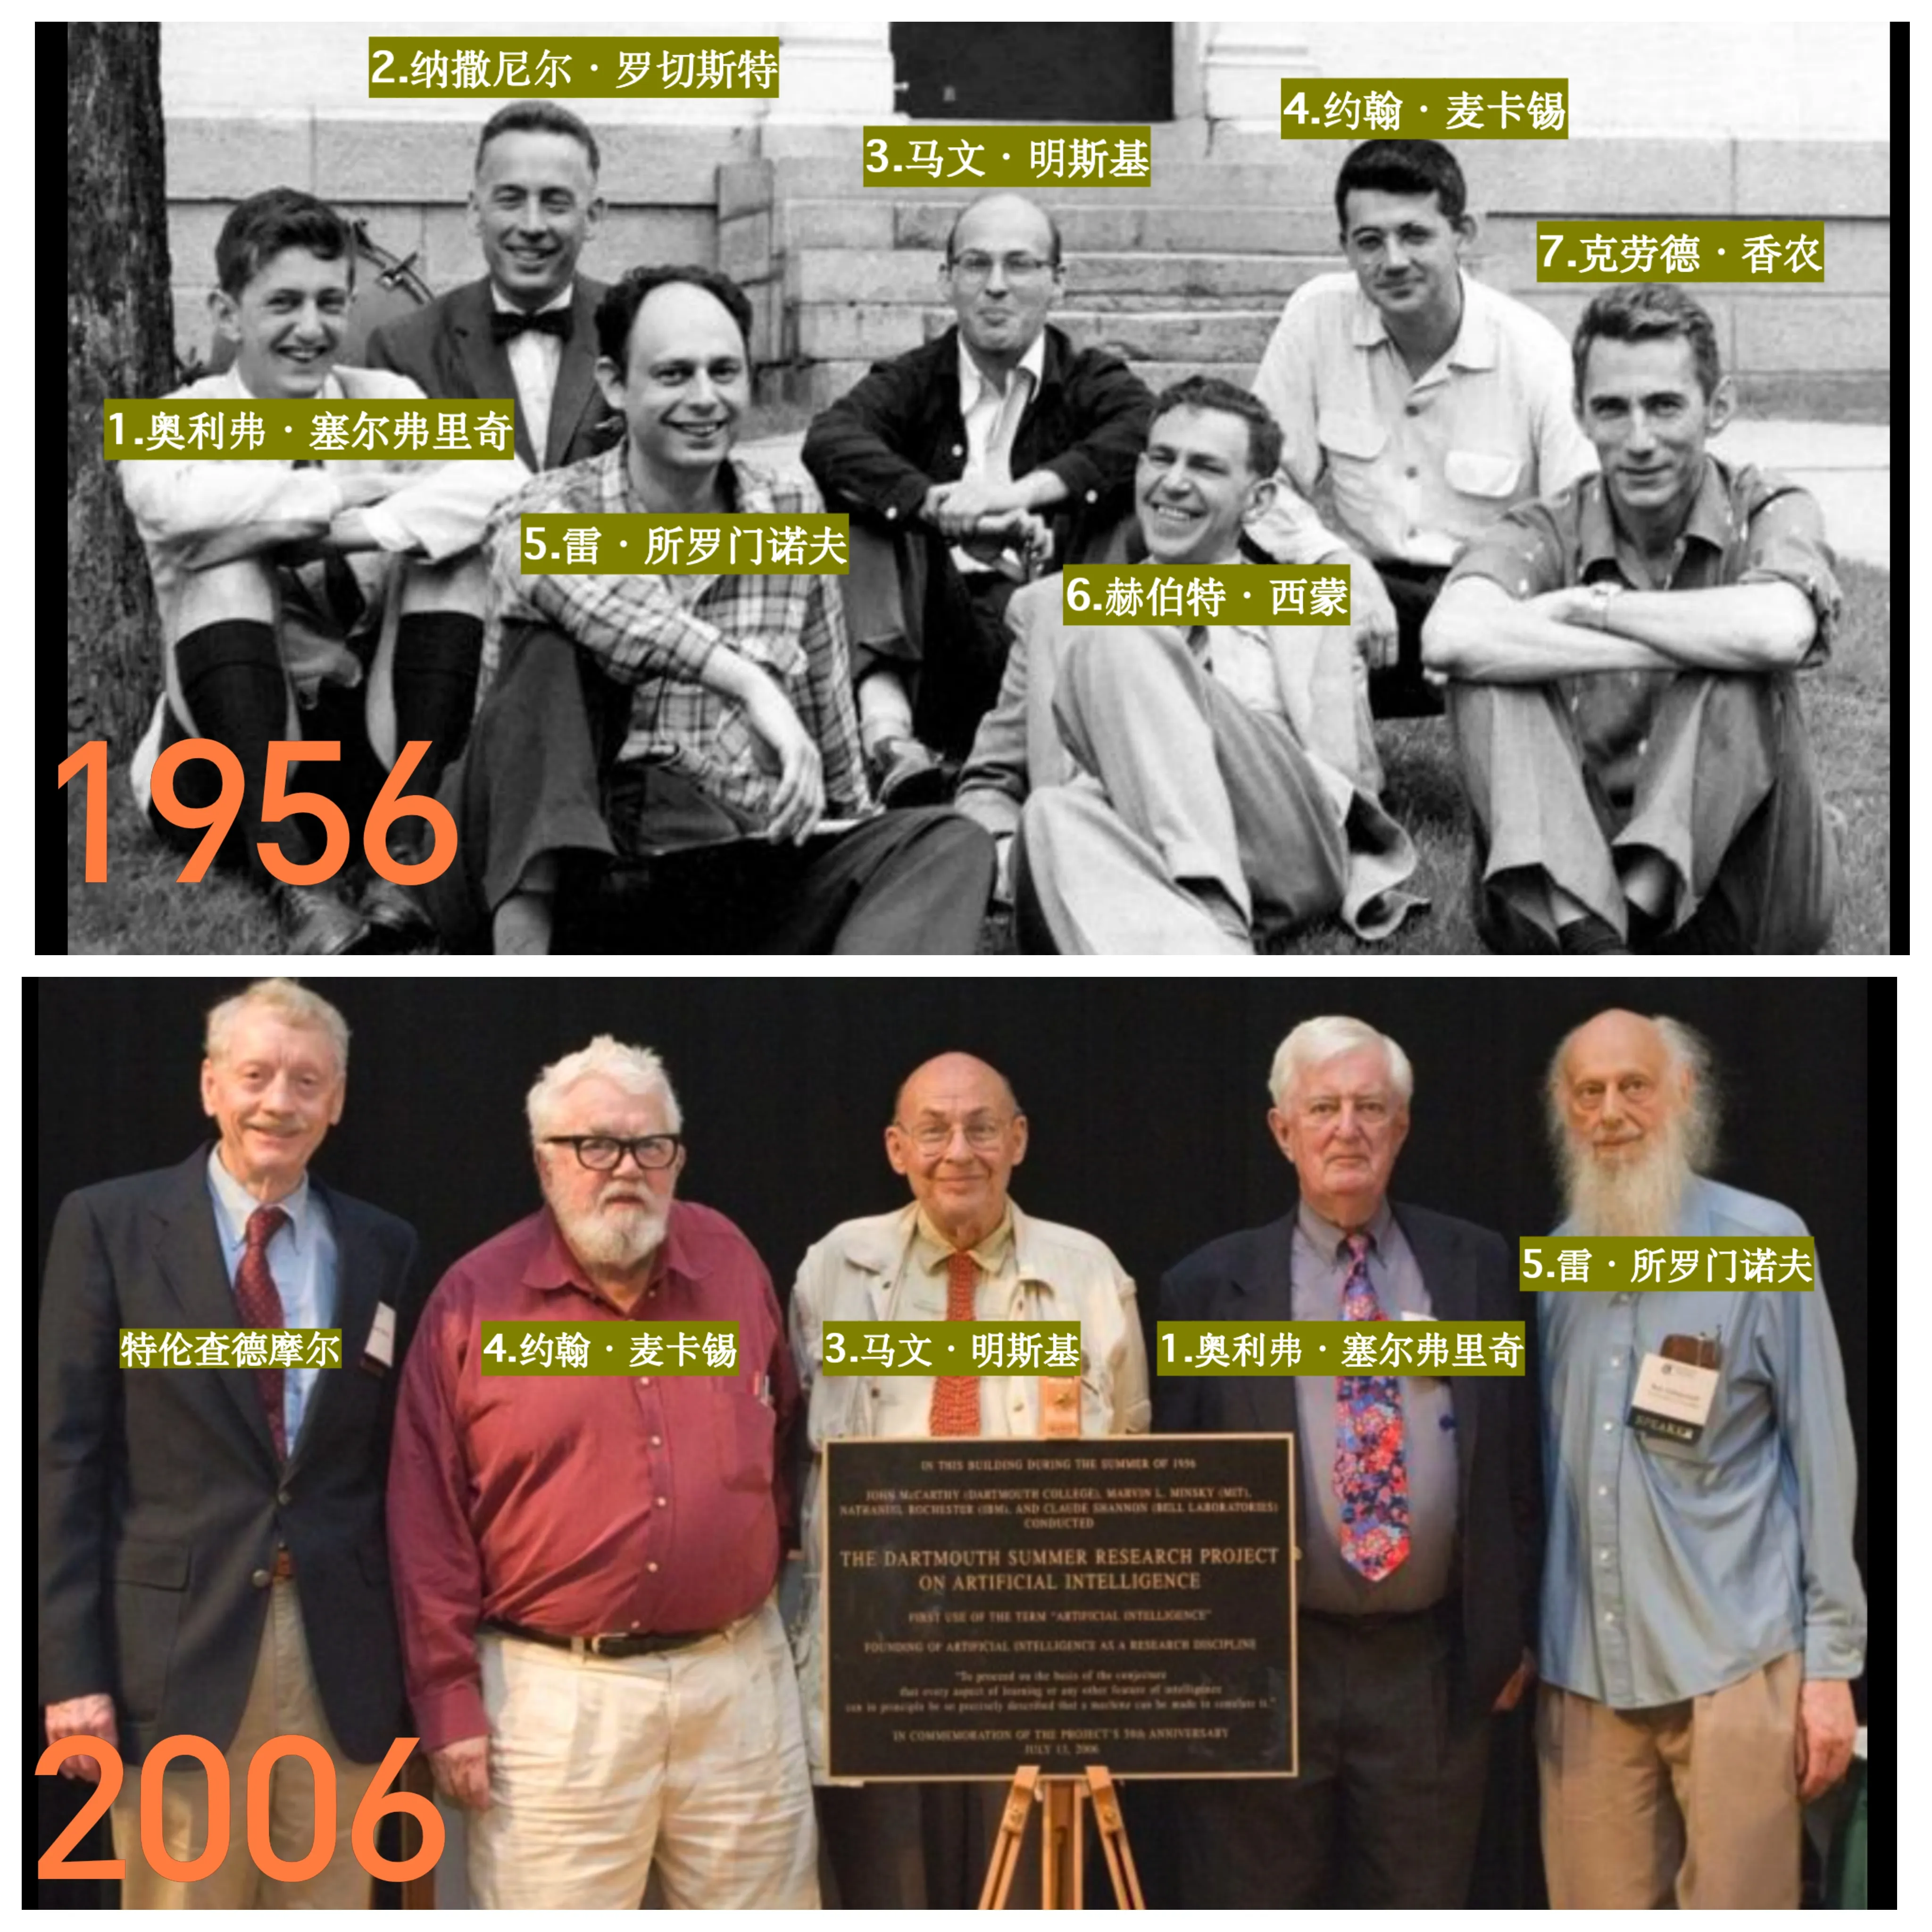
1956年夏天,在美国达特茅斯学院,一群科学家首次提出“Artificial Intelligence(人工智能)”这一名称,开启了AI时代的序幕。会议由 John McCarthy、Marvin Minsky、Claude Shannon 和 Nathaniel Rochester 发起,被视为人工智能学科的起点。2006年,在达特茅斯会议50周年纪念活动上,AI先驱们再次相聚。

照片拍摄于美国达特茅斯学院草坪(1956年) ,2006年达特茅斯AI会议50周年纪念合影(2026)。
达特茅斯50年再聚首

1956年达特茅斯会议照片,这7位科学家从上到下依次是:

  • 1.奥利弗・塞尔弗里奇 (Oliver Selfridge): 模式识别、机器感知领域先驱,被称作 “机器感知之父”,早期视觉 AI研究者。
  • 2.纳撒尼尔・罗切斯特 (Nathaniel Rochester) IBM资深研究员,达特茅斯会议四位发起人之一,最早研究人工神经网络的学者。
  • 3.马文・明斯基( Marvin Minsky ) AI 奠基人,MIT人工智能实验室联合创始人,1969 年图灵奖得主,框架理论创立者。
  • 4.约翰・麦卡锡( John McCarthy ) “人工智能(Artificial Intelligence)” 术语的创造者Lisp编程语言发明者,1971年图灵奖得主。
  • 5.雷・所罗门诺夫( Ray Solomonoff ) 通用人工智能、算法信息论先驱,提出所罗门诺夫归纳推理,奠定概率机器学习理论基础。
  • 6.赫伯特・西蒙 ( Herbert A. Simon ) 双料诺奖(诺贝尔经济学奖 + 图灵奖)得主,认知科学、符号主义 AI 核心奠基人,研究人类决策与机器逻辑推理。
  • 7.克劳德・香农 (Claude Elwood Shannon) 信息论之父,数字电路理论开创者,现代计算机、通信、信息科学的基石人物。

Read More

什么是大模型?它是如何工作的,应用场景又是什么?

系列文章见: 《回忆AI时代-从图灵机到人工智能》

什么是大模型

大模型(Large Model)通常指参数量非常庞大的人工智能模型,它就像一个经过海量知识训练的“数字大脑”,能够理解、推理、生成内容,并完成各种复杂任务。而LLM(Large Language Model,大语言模型) 是大模型中的一种。那大模型中什么叫“大”

  • 参数量大
  • 训练数据大
  • 计算规模大

参数量

模型/阶段 参数量
早期神经网络 几万 ~ 几百万
BERT 3.4 亿(340M)
GPT-3 1750 亿(175B)
现代大模型 数百亿 ~ 数万亿

训练数据大
大模型训练时会阅读海量数据,例如:

  • 书籍
  • 论文
  • 网站
  • 代码
  • 新闻
  • 对话数据

训练数据规模通常达到TB甚至PB级别。

计算规模大
训练一次先进大模型可能需要:

  • 数千张 GPU
  • 数周甚至数月训练时间
  • 数百万美元成本

大模型是怎么工作的

目前主流大模型基本基于:Transformer 架构(2017年提出)

1
2
3
4
5
6
7
8
9
10
11
12
13
海量数据

预训练(Pretraining)

获得语言能力

指令微调(SFT)

学会听懂人类指令

强化学习(RLHF)

更符合人类需求

大模型应用场景

大模型应用场景:

  • 文本能力
  • 推理能力
  • 多模态能力
文本能力 推理能力 多模态能力
* 写文章
* 写代码
* 翻译
* 总结
* 问答
* 鸡兔同笼
* 数学题
* 逻辑题
* 图片
* 语音
* 视频